目标检测需要同时回答两个问题:图像里有什么,以及目标位于什么位置。YOLO 用一次前向传播同时预测类别和边界框,在速度与精度之间取得了很好的平衡。但把普通 YOLO 的激活函数直接替换成脉冲神经元,并不会自动得到一个高效、准确的 SNN 检测器。
SNN(Spiking Neural Network,脉冲神经网络)以离散脉冲传递信息。没有脉冲时,突触计算可以不发生;有脉冲时,权重乘法也可转化为条件累加。这种事件驱动特性对事件相机很有吸引力。不过,脉冲化也带来表示量化误差和时间维计算,尤其是目标检测还要回归精确的框位置,误差更容易影响最终结果。
SpikeYOLO 是 Luo 等人在 ECCV 2024 提出的 SNN 目标检测模型。它的思路不是把 YOLOv8 原样“换成脉冲版”,而是保留 Backbone–Neck–Head 的宏观检测框架,重新设计适合 SNN 的微观特征块,并用 I-LIF 在整数激活训练与二值脉冲推理之间搭桥。本文先从整体数据流入手,再逐步拆解 LIF、I-LIF 和各类卷积块。论文和实现分别见论文与官方仓库。
为什么要重新设计 SNN 版 YOLO?
ANN 特征通常是稠密的实数张量;SNN 特征则是随时间演化的脉冲。二者的数值表示和计算方式并不相同。直接把复杂的 YOLO 模块逐层替换成脉冲神经元,可能导致脉冲在网络深处逐渐衰减,最终特征不足以支撑分类和定位。论文的消融实验也显示,在其设置下,将 YOLOv8 直接转换成脉冲版本,COCO 上的 mAP@50 从 ANN 的 67.2% 降到 46.8%。
SpikeYOLO 因此做了两层改造:一是简化特征提取模块,以更适合脉冲传播的 SNN Block 取代 YOLOv8 中较复杂的重复特征结构;二是引入 I-LIF,训练时允许神经元输出小范围整数,减少二值化损失,推理时再把整数拆成 0/1 脉冲。换句话说,检测器的宏观任务流沿用 YOLOv8,脉冲网络的微观计算单元则重新设计。
论文报告,在 COCO 上,68.8M 参数配置取得 66.2% mAP@50 和 48.9% mAP@50:95;在 Gen1 事件数据集上,23.1M 参数配置取得 67.2% mAP@50。论文还报告了相同架构下相对 ANN 的能效优势。需要注意,这些能耗数字来自论文采用的运算能耗模型,并不等同于在某款 SpikeYOLO 专用芯片上的实测结果。
从输入到检测:SpikeYOLO 的整体结构
SpikeYOLO 的数据流可以先概括为:
图像/事件序列 → Backbone 提取多层特征 → Neck 融合多尺度特征 → P3/P4/P5 检测头 → 类别与边界框
输入统一表示为 :静态图像可以沿时间维重复 次;事件相机输入则先在时间窗口内聚合成 个切片。 是输入的逻辑时间步数,后文的 则是 I-LIF 允许的最大整数激活值,两者不是同一个参数。
输入 [T, C, H, W]
       │
       ▼
Backbone:下采样 + SNN Block + SPPF
       │          └─ 提取不同分辨率的特征
       ▼
Neck:上采样/拼接,再下采样/拼接
       │
       ├── P3:高分辨率,小目标
       ├── P4:中分辨率,中目标
       └── P5:低分辨率,大目标
                │
                ▼
      anchor-free SpikeDetect
                │
                ▼
       类别分数与边界框
在官方 snn_yolov8.yaml 中,Backbone 以一次 、stride=4 的卷积开始,之后继续下采样;以 640×640 输入为例,三个检测尺度对应约 80×80、40×40 和 20×20 特征图,即 stride 8、16、32。Neck 通过上采样和跨层 concat 建立自顶向下的特征融合,再通过下采样和 concat 建立自底向上的融合。末端 SpikeDetect 接收 P3/P4/P5 三个尺度,使用 YOLOv8 风格的 anchor-free 检测头。
这里的“沿用 YOLOv8”指的是 Backbone–Neck–Head 的总体组织方式,不是逐层照搬原版 YOLOv8:例如特征块、时序维、脉冲神经元和检测分支都做了适配。对应的网络配置可查看官方 YAML。
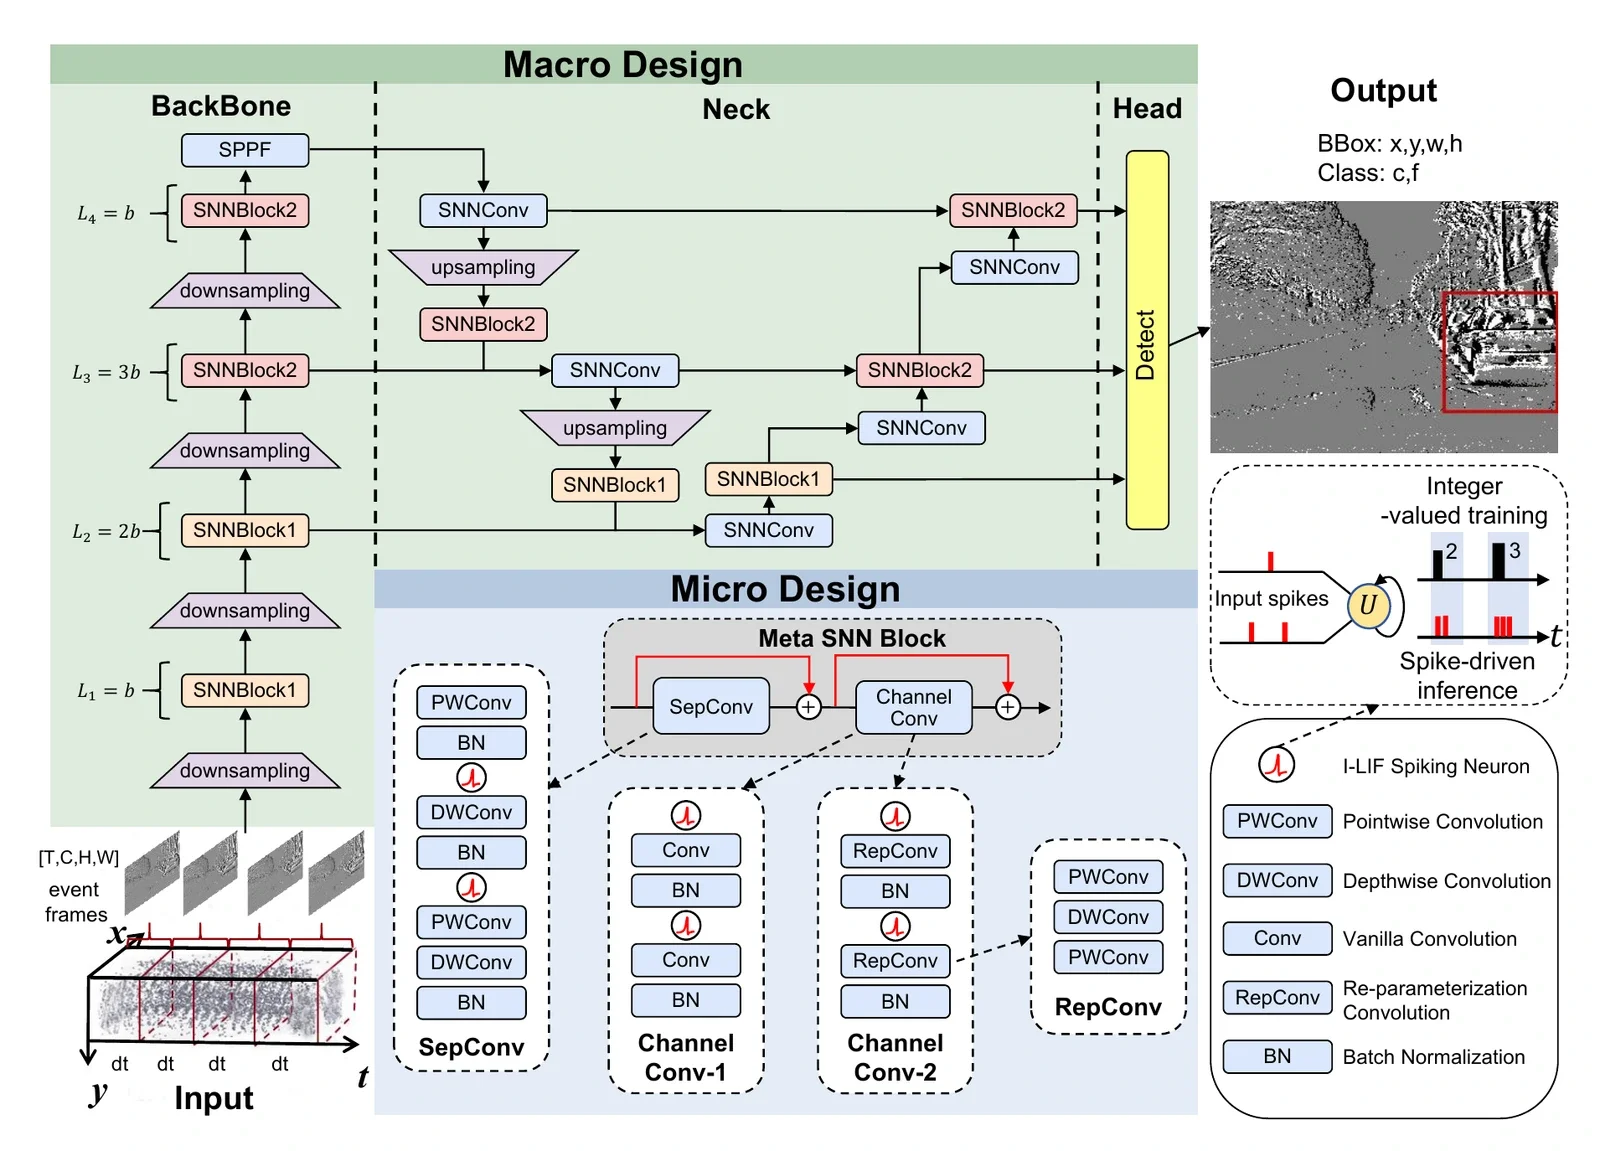
Backbone:逐级降采样,构造语义层次
Backbone 的任务是把输入变成从细节到语义逐渐抽象的特征。以官方 snn_yolov8.yaml 的 s scale、640×640 输入为例,MS_GetT 先补上时间维;随后首层用 、stride=4 卷积降至 160×160。注意首层直接处理连续输入,不先执行 mem_update;从后续层开始才进入脉冲神经元和 SNN 卷积。
之后 Backbone 每个 stage 通过 stride=2 卷积继续降采样,并在 stage 内堆叠脉冲块:stride 4、8 阶段主要使用 MS_AllConvBlock(SNN-Block-1),stride 16、32 阶段主要使用 MS_ConvBlock(SNN-Block-2)。在 s scale 下,四个阶段的通道数分别为 64、128、256、512;最深层再接 SpikeSPPF 汇聚多尺度上下文。Neck 会从 stride 8、16、32 三处取特征作为横向连接。
Neck:自顶向下传语义,再自底向上补细节
Neck 可以看作 FPN 与 PAN 风格的双向特征融合。先从 Backbone 最深层开始:用 SNNConv 调整通道、上采样 2 倍,再与 stride 16 的 Backbone 特征 concat;经过 SNN Block 融合后继续上采样,与 stride 8 特征 concat,形成高分辨率的 P3 路径。
接着,Neck 把 P3 路径用 stride=2 卷积降采样,与前面的 stride 16 特征再次 concat,融合出 P4;再降采样一次,与最深层特征 concat,得到 P5。这样,P3 保留较多空间细节,P5 拥有较强的语义信息,P4 则位于两者之间。以 s scale 为例,送入检测头的特征大致为 P3 [128,80,80]、P4 [256,40,40]、P5 [512,20,20](格式为 [C,H,W])。
Head:三个尺度分别预测类别与边界框
Head 接收 P3/P4/P5 三张特征图,在每个尺度上分别运行分类分支和边界框回归分支。SpikeYOLO 使用 anchor-free 方式,不为每个位置预设一组宽高不同的 anchor box;每个网格位置根据预测的类别分数和四边距离恢复目标框。回归分支采用 DFL 分布表示,再通过积分和网格参考点解码为 。三个尺度的预测合并后形成最终候选结果。检测头内部的分支结构和 DFL 计算会在后文单独展开。
下面先从单个神经元的状态更新开始,再回到卷积块如何把这些神经元组织起来。
LIF 神经元
LIF神经元因其在生物可行性和计算复杂性之间的平衡,是构建SNN最受欢迎的神经元。
离散的 LIF 方程
其中:
- 是当前时间步的输入加权和, 是上一时间步复位后的膜电位。
- 是积分后的候选膜电位, 是发放阈值。
- 是输出脉冲, 是当前时间步复位并泄漏后的状态。
- 是泄漏系数。该式按论文中的阈值归一化写法表达软复位。
论文的 LIF 更新式是软复位,而不是“发放后直接设为固定复位电位”的硬复位。原先的 LIF 示意图画的是硬复位公式,因此本文暂不将它作为配图,避免图文不一致。
I-LIF 神经元
SpikeYOLO 提出 Integer Leaky Integrate-and-Fire(I-LIF)。与普通 LIF 在每个时间步输出 0/1 不同,I-LIF 在训练阶段输出 到 的整数,以缓解二值脉冲带来的量化误差。
I-LIF 的方程
其中:
- 为 I-LIF 的最大整数输出值。
- 为取整函数。
- 将 限制在 。
- 是泄漏系数;论文实验中设为 0.25。
论文中的离散方程是概念定义;官方训练实现还明确了状态更新顺序:mem_update 在首个时间步令 mem = x[0],之后按 mem = (mem_old - spike.detach()) * decay + x[t] 更新,再用 MultiSpike4 将膜电位取整并裁剪到 。因此,解释方程时应把“先减去已发放量,再乘泄漏系数”的软复位顺序说清楚。对应代码见 mem_update 与 MultiSpike4。
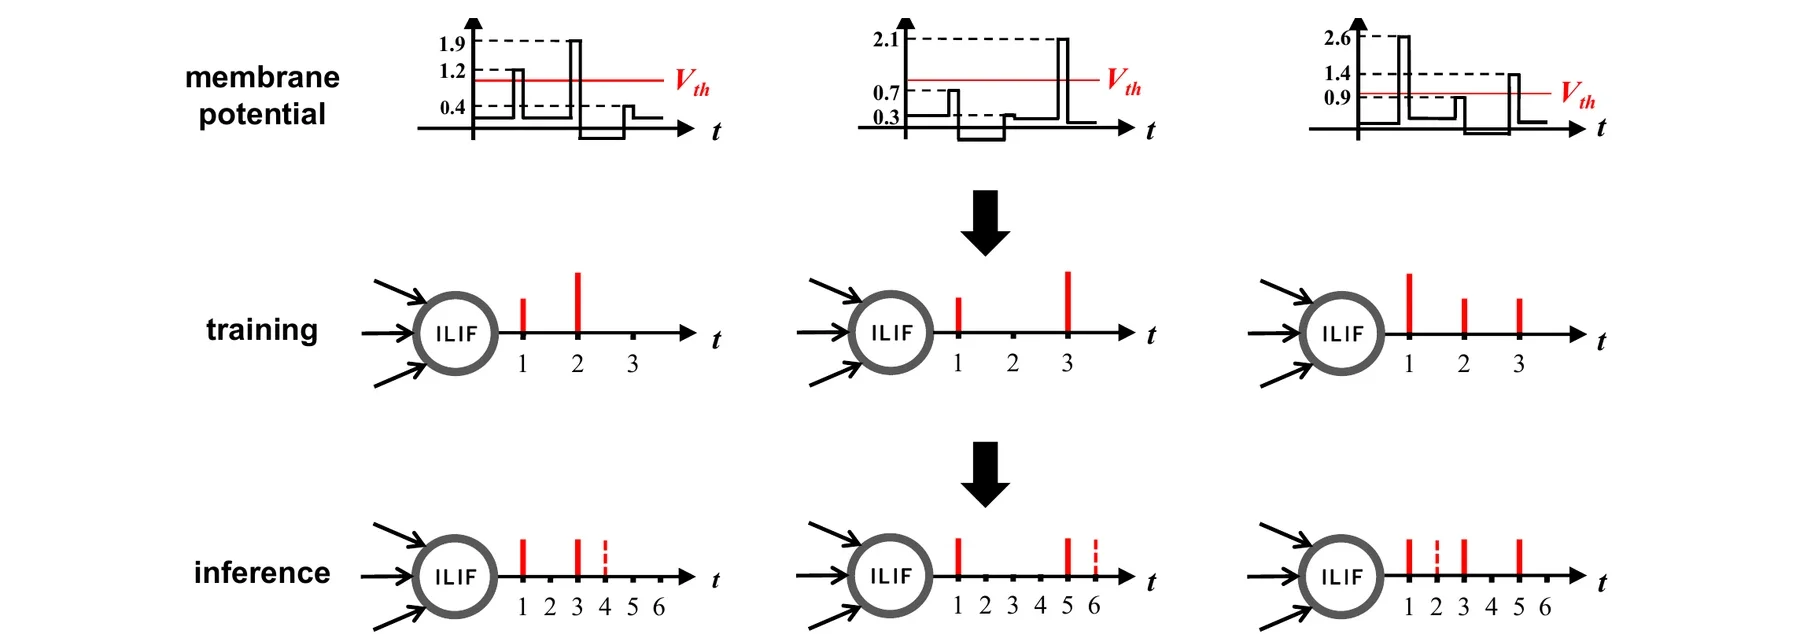
训练和推理的区别
训练阶段
整数值发放,降低二值化带来的信息损失。
推理阶段
推理时,把整数输出拆到 个虚拟时间步中的二值脉冲。例如,一个时间步输出 2,可以用两个值为 1 的脉冲表示:
每个展开后的脉冲只取 0 或 1,后续卷积就可以对实际发放的位置做稀疏累加(AC),而不必计算整数激活与权重之间的乘累加(MAC)。
论文进一步将时间步数从 扩展为 ,并要求整数输出与展开后的二值脉冲数量满足
其中 。论文给出的是数量约束;官方二值推理代码 yolo_spikformer_bin.py 使用 cumulative/unary 展开:对整数值 ,前 个虚拟步为 1,其余为 0。该分支的 mem_update 会先对输入时间维求和,再量化并展开;原训练分支则逐时间步更新膜电位,两者不是逐行等价的实现。官方 README 特别说明,二值推理版使用对应的二值推理权重,不能简单替换原整数模型文件后继续加载原 checkpoint。
SpikeYOLO 的微观架构
一些常见的卷积
卷积(互相关版)
深度学习中的卷积运算被定义为
深度学习中的普通卷积会同时沿着空间维度和输入通道维度进行加权求和。
以下公式假设 stride 为 1,并忽略 padding 和 bias。
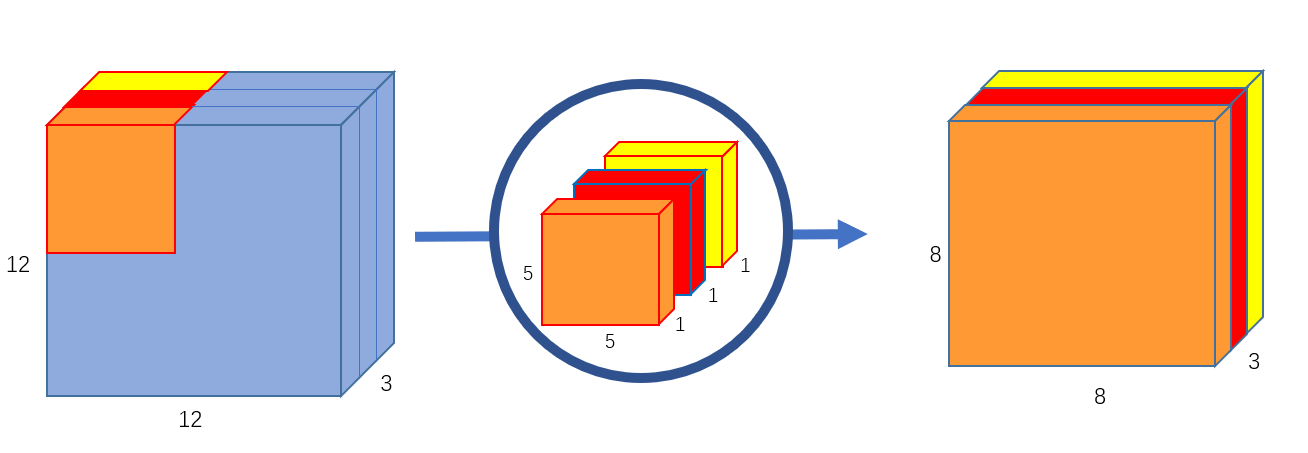
深度卷积(Depthwise Conv)
深度卷积被定义为
其中:
- :输入特征图第 个通道在位置 的值。
- :第 个通道独立使用的卷积核。
- :卷积核的高和宽。
- :输出特征图。
深度卷积的求和只遍历空间维度,不对通道进行求和,各通道独立卷积。深度卷积运算缺少通道间的特征融合 ,并且运算前后通道数无法改变。
逐点卷积(Pointwise Conv)
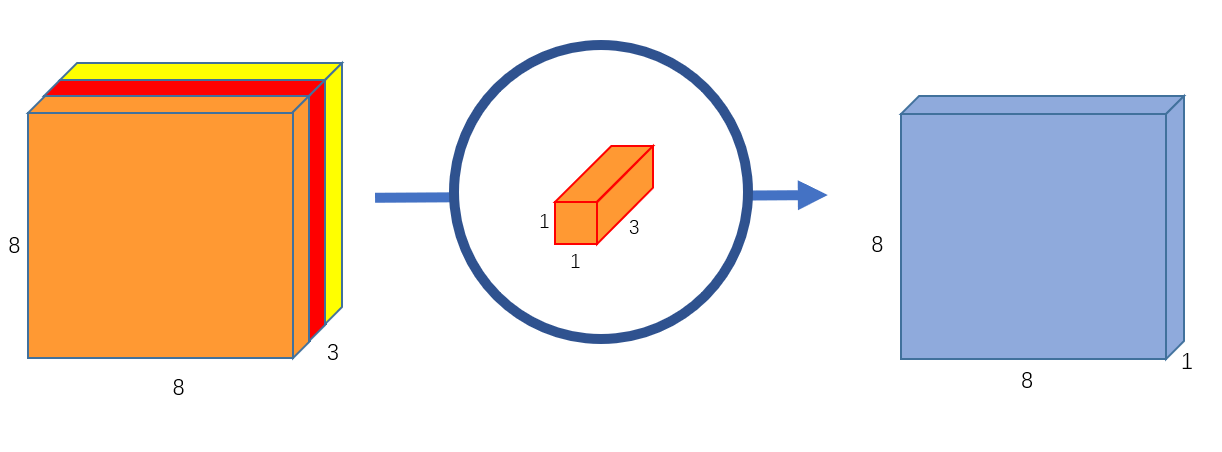
逐点卷积被定义为
其中:
- :输入位置 的第 个通道值。
- :输入通道 到输出通道 的权重。
- :输出通道索引。
- :输出位置 的第 个通道值。
逐点卷积通常用于融合不同通道。
倒置可分离卷积(SepConv)
论文将空间混合器写成如下抽象形式:
其中 Pointwise/Depthwise 卷积和脉冲神经元交替组合;较大的 depthwise kernel(论文设为 )扩大空间感受野,后续的 depthwise 卷积进一步融合局部空间信息。需要区分论文公式与代码版本:官方训练实现 yolo_spikformer.py 的 SepConv 使用 pointwise 扩张、可配置 kernel 的 depthwise 卷积,以及 SepRepConv(depthwise 后接 pointwise 投影);二值推理版 yolo_spikformer_bin.py 则显式包含末尾的逐通道卷积。讨论具体算子顺序时,应注明对应的实现分支。
论文中的算子定义见公式 (4);官方训练分支的 SepConv 实现在 yolo_spikformer.py,二值推理分支则在 yolo_spikformer_bin.py。两者结构有差异,不应把其中一个代码片段当作两种模型共用的定义。
重参数化卷积(RepConv)
论文把通道混合中的 RepConv 定义为:
其结构是 pointwise → depthwise → pointwise 。论文称该结构可在推理阶段重参数化为标准卷积。官方 Python 实现中的 RepConv 则以 BNAndPadLayer 和分解卷积组织计算;不要把它与 Ultralytics 原生 RepConv 类混为一谈。
标准脉冲卷积(SNNConv)
一个标准脉冲卷积被定义为
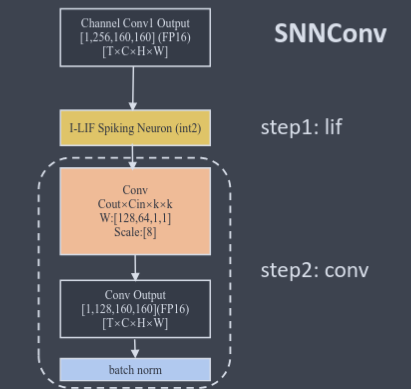
官方实现中的 MS_StandardConv.forward() 按 mem_update → Conv2d → BatchNorm 的顺序计算,并在卷积前合并时间维、卷积后恢复时间维。可对照 yolo_spikformer.py。
Meta SNN Block
SpikeYOLO 借鉴 Meta-SpikeFormer 的 meta SNN block。它和 Transformer block 一样把特征处理拆成“空间/token 混合”和“通道混合”,但这里的空间混合器是脉冲卷积,而不是自注意力。
一个meta SNN Block可以写作
两个加号都是残差连接:先用 SepConv 混合空间信息,再对结果做 ChannelConv 并再次残差相加。残差支路让输入特征可以直接向后传播,降低深层 SNN 特征退化风险。官方实现的 MS_ConvBlock 和 MS_AllConvBlock 都遵循这一双残差骨架。
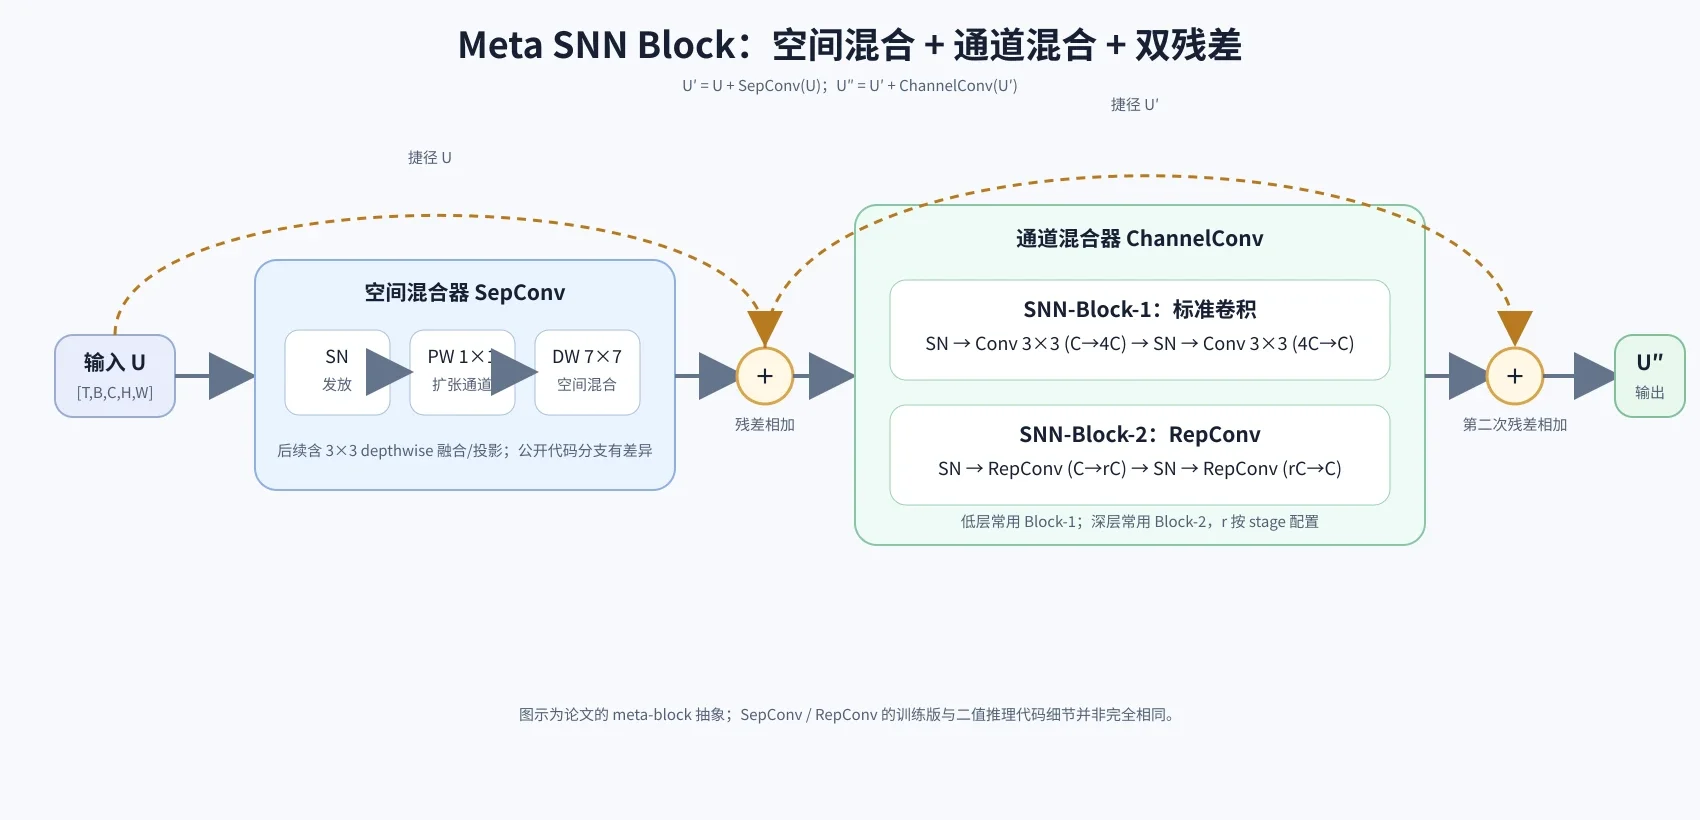
SNN-Block-1 和 SNN-Block-2
SNN-Block-1 和 SNN-Block-2 的区别主要在于 ChannelConv(通道混合器)的实现。
对于 SNN-Block-1:
对于 SNN-Block-2:
因此,SNN-Block-1 和 SNN-Block-2 的主要差别是通道混合器:前者使用扩张比为 4 的标准 卷积;后者使用 RepConv,扩张比按 stage 配置。官方代码分别对应 MS_AllConvBlock 和 MS_ConvBlock;在低层特征阶段使用 Block-1,在更深阶段使用 Block-2。论文的消融实验显示,把早期 Block-1 换成 Block-2,或把深层 Block-2 换成 Transformer block,都没有优于基线。
SpikeYOLO 逐层解析
下面逐层追踪官方 snn_yolov8.yaml。为了让形状具体可读,固定使用 s scale、640×640 输入、nc=80;其他 scale 会改变通道数,输入尺寸也会改变空间尺寸。表中形状只写 [C,H,W],省略 batch 和时间维:整数训练版的完整特征通常是 [T,B,C,H,W],二值推理版还可能在神经元处展开 个虚拟时间步,但不会改变这里列出的空间/通道形状。s scale 的深度系数为 0.33,YAML 中重复数 3、6、9、3 实际缩放为 1、2、3、1。
卷积输出的空间尺寸按下式计算:
其中 、、 分别为 kernel、stride、padding。后文的 SNNConv 记作“神经元 → 卷积 → BN”;除输入 stem 外,MS_StandardConv 会先通过 mem_update 生成脉冲特征。
几个会反复出现的操作可写成:
Backbone:第 0–9 层
| 层 | 模块 / 输入 → 输出 | 计算细节 |
|---|---|---|
| 0 | MS_GetT:[3,640,640] → [3,640,640] | 为输入补时间维。此 YAML 的 ;若设置更大的 ,静态图像会沿时间维重复。 |
| 1 | MS_DownSampling:[3,640,640] → [64,160,160] | 首层 、stride=4、padding=2 卷积 + BN。它直接处理连续输入,不在卷积前放脉冲神经元。输出尺寸由卷积尺寸公式得到。 |
| 2 | MS_AllConvBlock ×1:[64,160,160] → [64,160,160] | Backbone 的第一个 SNN-Block-1,通道混合扩张比 ;不改变空间分辨率。 |
| 3 | MS_DownSampling:[64,160,160] → [128,80,80] | 先 mem_update,再 、stride=2、padding=1 卷积 + BN。 |
| 4 | MS_AllConvBlock ×2:[128,80,80] → [128,80,80] | 两个 SNN-Block-1;输出作为 Neck 的高分辨率横向特征(P3 路径)。 |
| 5 | MS_DownSampling:[128,80,80] → [256,40,40] | mem_update 后接 、stride=2、padding=1 卷积 + BN。 |
| 6 | MS_ConvBlock ×3:[256,40,40] → [256,40,40] | 三个 SNN-Block-2,mlp_ratio=3、SepConv kernel=7;输出作为 Neck 的中分辨率横向特征(P4 路径)。 |
| 7 | MS_DownSampling:[256,40,40] → [512,20,20] | mem_update 后接 、stride=2、padding=1 卷积 + BN。 |
| 8 | MS_ConvBlock ×1:[512,20,20] → [512,20,20] | 深层 SNN-Block-2,mlp_ratio=2、SepConv kernel=7。 |
| 9 | SpikeSPPF:[512,20,20] → [512,20,20] | 先 SNNConv 将通道减半到 256;连续三次 、stride=1 最大池化;拼接池化前及三次池化结果([1024,20,20]);再用 SNNConv 融合回 512 通道。空间尺寸不变。 |
把池化过程写成公式,令 ,并令 (),则
Block-1 / Block-2 内部均遵循前文的双残差式:,然后 。MS_AllConvBlock 的通道混合器由两个标准 SNNConv 组成,通道先扩张再投影回原维度;MS_ConvBlock 则以两个 RepConv 代替这对标准卷积。
Neck:第 10–25 层
| 层 | 模块 / 输入 → 输出 | 计算细节 |
|---|---|---|
| 10 | MS_StandardConv:[512,20,20] → [256,20,20] | SNNConv 做通道投影,作为顶层语义分支。 |
| 11 | Upsample ×2:[256,20,20] → [256,40,40] | 最近邻上采样,只扩大空间尺寸。 |
| 12 | MS_ConvBlock:[256,40,40] → [256,40,40] | SNN-Block-2,mlp_ratio=3,先处理上采样后的语义特征。 |
| 13 | Concat(layer 6):[256,40,40] + [256,40,40] → [512,40,40] | 沿通道维拼接 Backbone 的 P4 特征,融合高层语义与中层空间细节。 |
| 14 | MS_StandardConv:[512,40,40] → [128,40,40] | SNNConv 压缩/投影通道。 |
| 15 | Upsample ×2:[128,40,40] → [128,80,80] | 最近邻上采样到 P3 分辨率。 |
| 16 | MS_AllConvBlock:[128,80,80] → [128,80,80] | SNN-Block-1,mlp_ratio=4。 |
| 17 | Concat(layer 4):[128,80,80] + [128,80,80] → [256,80,80] | 拼接 Backbone 的高分辨率特征。 |
| 18 | MS_StandardConv:[256,80,80] → [128,80,80] | SNNConv 投影通道。 |
| 19 | MS_AllConvBlock:[128,80,80] → [128,80,80] | SNN-Block-1,mlp_ratio=4;这是送往检测头的 P3 特征。 |
| 20 | MS_StandardConv:[128,80,80] → [128,40,40] | 、stride=2 SNNConv,下采样回 P4 尺度。 |
| 21 | Concat(layer 14):[128,40,40] + [128,40,40] → [256,40,40] | 与 Neck 自顶向下路径保留的 P4 特征拼接。 |
| 22 | MS_ConvBlock:[256,40,40] → [256,40,40] | SNN-Block-2,mlp_ratio=3;输出 P4 检测特征。 |
| 23 | MS_StandardConv:[256,40,40] → [256,20,20] | 、stride=2 SNNConv,下采样到 P5 尺度。 |
| 24 | Concat(layer 10):[256,20,20] + [256,20,20] → [512,20,20] | 与来自 SPPF 的顶层语义分支拼接。 |
| 25 | MS_ConvBlock:[512,20,20] → [512,20,20] | SNN-Block-2,mlp_ratio=1;输出 P5 检测特征。 |
上述 concat 都是沿通道维拼接,不是逐元素相加。Neck 的数据路径可以概括成 P5 上采样融合 P4 → 再上采样融合 P3 → 下采样回融 P4 → 再下采样回融 P5。它让每个检测尺度都同时拥有来自 Backbone 和其他尺度的特征。
第 26 层:SpikeDetect
第 26 层 SpikeDetect 的输入是 [19,22,25] 三个特征:P3 [128,80,80]、P4 [256,40,40]、P5 [512,20,20]。SpikeDetect 延续 YOLOv8 的 anchor-free 设计。每个尺度有两个独立分支:cv2 回归框分布,cv3 预测类别;每条分支先经过两个 SpikeConv,再用 卷积输出。以默认 reg_max=16 为例,回归分支输出 个分布值,类别分支输出 nc=80 个类别分数,所以每个网格点的原始输出通道为 。
| 输入尺度 | 回归分支原始输出 | 分类分支原始输出 | 拼接后 |
|---|---|---|---|
P3 [128,80,80] | [64,80,80] | [80,80,80] | [144,80,80] |
P4 [256,40,40] | [64,40,40] | [80,40,40] | [144,40,40] |
P5 [512,20,20] | [64,20,20] | [80,20,20] | [144,20,20] |
第 个尺度的两个预测分支可写作:
其中 是该尺度输入特征, 是 个框分布通道, 是 80 个类别通道。
框分支随后通过 DFL(Distribution Focal Loss)积分模块。对每条边 的 16 个离散位置做 softmax,再用固定权重求期望:
四个距离经 dist2bbox 相对网格参考点解码为 ,再乘以该特征层的 stride;类别分支则经过 sigmoid。源码中的 make_anchors 生成的是特征图网格中心点(参考点),不是 YOLOv5 那类预设宽高的 anchor box。需要注意,DFL 的 softmax、加权求和和框解码仍包含常规数值运算,因此检测头并非从头到尾都是二值脉冲累加。
推理时,三个尺度共有 个网格位置。DFL 将每个位置的 64 个框分布解码成 4 个框坐标,再与 80 个类别分数拼接,因此 nc=80 时输出形状为 [B,84,8400],其中 。训练模式则返回每个尺度尚未解码的原始预测张量。
官方 SpikeDetect 的两个分支、reg_max、DFL 与解码实现可见yolo_spikformer.py;网络配置将第 19、22、25 层的特征送入检测头,见snn_yolov8.yaml。
附录
LIF 相关名词解释
| 英文术语 | 中文名称 | 含义 |
|---|---|---|
| Membrane Potential | 膜电位 | 神经元内部的状态变量,反映输入累积后的电位水平 |
| Resting Potential | 静息电位 | 没有有效输入时,膜电位趋向的基准值 |
| Membrane Time Constant | 膜时间常数 | 决定膜电位变化与衰减速度的参数,经典 RC 模型中 |
| Leak | 泄漏 | 膜电位逐渐向静息电位回归的过程 |
| Integration | 积分 | 累积当前和历史输入的过程 |
| Firing Threshold | 发放阈值 | 膜电位达到该值时触发脉冲的阈值 |
| Spike / Spike Train | 脉冲 / 脉冲序列 | 单次发放事件 / 一段时间内的发放事件序列 |
| Reset | 复位 | 神经元发放后对膜电位执行的状态更新 |
| Hard Reset | 硬复位 | 将膜电位直接设置为复位电位 |
| Soft Reset | 软复位 | 从膜电位中减去阈值,保留超出部分 |
| Synaptic Weight | 突触权重 | 决定输入脉冲对目标神经元影响大小的权重 |
| Leak Factor | 泄漏系数 | 离散模型中控制历史状态保留程度的系数 |
| Time Step | 时间步 | 数字仿真中一次状态更新所对应的离散时间单位 |
| Refractory Period | 不应期 | 发放后的一段特殊时期;基础 LIF 模型不一定显式实现 |
| Surrogate Gradient | 替代梯度 | 训练时用于近似不可导脉冲函数梯度的方法 |
SNN 与 I-LIF 术语
| 英文术语 | 中文名称 | 含义 |
|---|---|---|
| SNN (Spiking Neural Network) | 脉冲神经网络 | 用离散脉冲在神经元之间传递信息的网络;神经元还保存随时间更新的内部状态。 |
| Firing Rate | 发放率 | 一段时间内发放脉冲的比例或频率;它会影响事件驱动计算量。 |
| Timestep () | 时间步 | SNN 离散状态更新的逻辑步数。静态图像可沿时间维重复,事件流也可切成 个输入帧。 |
| Maximum Integer Value () | 最大整数发放值 | I-LIF 单次训练输出的上限;二值推理时,一个整数激活最多对应 个虚拟二值脉冲步。 |
| I-LIF | 整数 LIF 神经元 | 训练时输出 的整数以减轻量化误差,推理时再展开为二值脉冲。 |
| Cumulative / Unary Coding | 累积式/一元编码 | 将整数 表示为 个 1 和其余 0;官方二值推理实现按这种方式展开虚拟时间步。 |
| AC / MAC | 累加 / 乘累加 | AC 是加法累积;MAC 是乘法后累积。二值 spike 与权重相乘可通过“有 spike 才累加”实现稀疏 AC。 |
| Batch Normalization (BN) | 批归一化 | 根据训练统计量缩放/平移特征;推理时常可与卷积权重融合。 |
记号提醒: 是模型的逻辑时间步数, 是 I-LIF 整数输出的最大值;论文中的二值推理长度可写为 。不要把 当成卷积通道数或模型宽度系数。
卷积与特征融合术语
| 英文术语 | 中文名称 | 含义 |
|---|---|---|
| Feature Map | 特征图 | 卷积网络中间张量的空间表示;常用 [C,H,W] 描述通道数、高度和宽度。 |
| Channel () | 通道 | 特征图的特征维度;普通卷积会对输入通道加权求和,生成输出通道。 |
| Kernel / Stride / Padding | 卷积核 / 步长 / 填充 | 卷积窗口大小、窗口移动距离和边界补值方式;stride 大于 1 时通常会降低空间分辨率。 |
| Standard Convolution | 标准卷积 | 同时混合空间邻域和输入通道,输出通道数由卷积核决定。 |
| Depthwise Convolution | 深度卷积 | 每个输入通道各自做空间卷积,不在通道间求和;SpikeYOLO 用它降低空间混合的计算量。 |
| Pointwise Convolution | 逐点卷积 | 卷积,在每个空间位置混合通道,常用于扩张、压缩或投影通道数。 |
| SepConv | 倒置可分离卷积 | 先用 pointwise 扩张通道,再用 depthwise 卷积做空间混合,之后投影回目标通道数;SpikeYOLO 将其用于 SNN Block 的空间混合。 |
| RepConv | 重参数化卷积 | SpikeYOLO 论文中的分解卷积模块,由 pointwise、depthwise、pointwise 操作组成;论文描述其可在推理阶段重参数化。不要与 Ultralytics 原生同名模块混淆。 |
| Residual / Shortcut | 残差 / 捷径连接 | 将模块输入直接加到变换结果上,例如 ,帮助保留输入信息。 |
| Concat | 拼接 | 沿通道维把多个特征图合并;与逐元素相加不同,拼接会增加通道数。 |
| SPPF | 快速空间金字塔池化 | 通过连续最大池化构造不同有效感受野,并拼接后融合,使特征图保持原空间尺寸。 |
| FPN / PAN | 特征金字塔 / 路径聚合网络 | FPN 通常自顶向下传递高层语义;PAN 再自底向上融合定位细节。SpikeYOLO Neck 采用上采样、concat、下采样的双向融合路径。 |
检测头术语
| 英文术语 | 中文名称 | 含义 |
|---|---|---|
| P3 / P4 / P5 | 多尺度特征层 | 三种分辨率的检测特征。本文 640 输入的示例中分别为 80×80、40×40、20×20;高分辨率层通常更有利于小目标。 |
| Detection Stride | 检测步长 | 输入图像尺寸与某检测特征图尺寸的比例;P3/P4/P5 对应 stride 8/16/32。它不同于单个卷积层的 stride 参数。 |
| Anchor-free | 无锚框 | 不为每个位置枚举预设宽高的 anchor box;SpikeYOLO 在网格参考点上预测类别和边界框距离。 |
| Anchor Point | 网格参考点 | 特征图网格中心在输入坐标系中的位置;源码变量虽名为 anchors,这里表示参考点,而非预设尺寸的锚框。 |
nc | 类别数 | 数据集中的目标类别数量。每个位置有 nc 个分类分数。 |
reg_max | 回归分箱上限 | 每条边用多少个离散位置表示距离;默认 16,所以四边共有 个回归 logits。 |
| DFL (Distribution Focal Loss) | 分布焦点损失/积分解码 | 训练时监督边界距离的离散分布;推理时对分布做 softmax,并用 加权求期望,恢复连续距离。 |
| NMS (Non-Maximum Suppression) | 非极大值抑制 | 根据分数和框重叠度过滤重复候选框的后处理步骤;它不属于卷积特征提取本身。 |